Искусственный интеллект выполнил опасные команды при управлении роботами
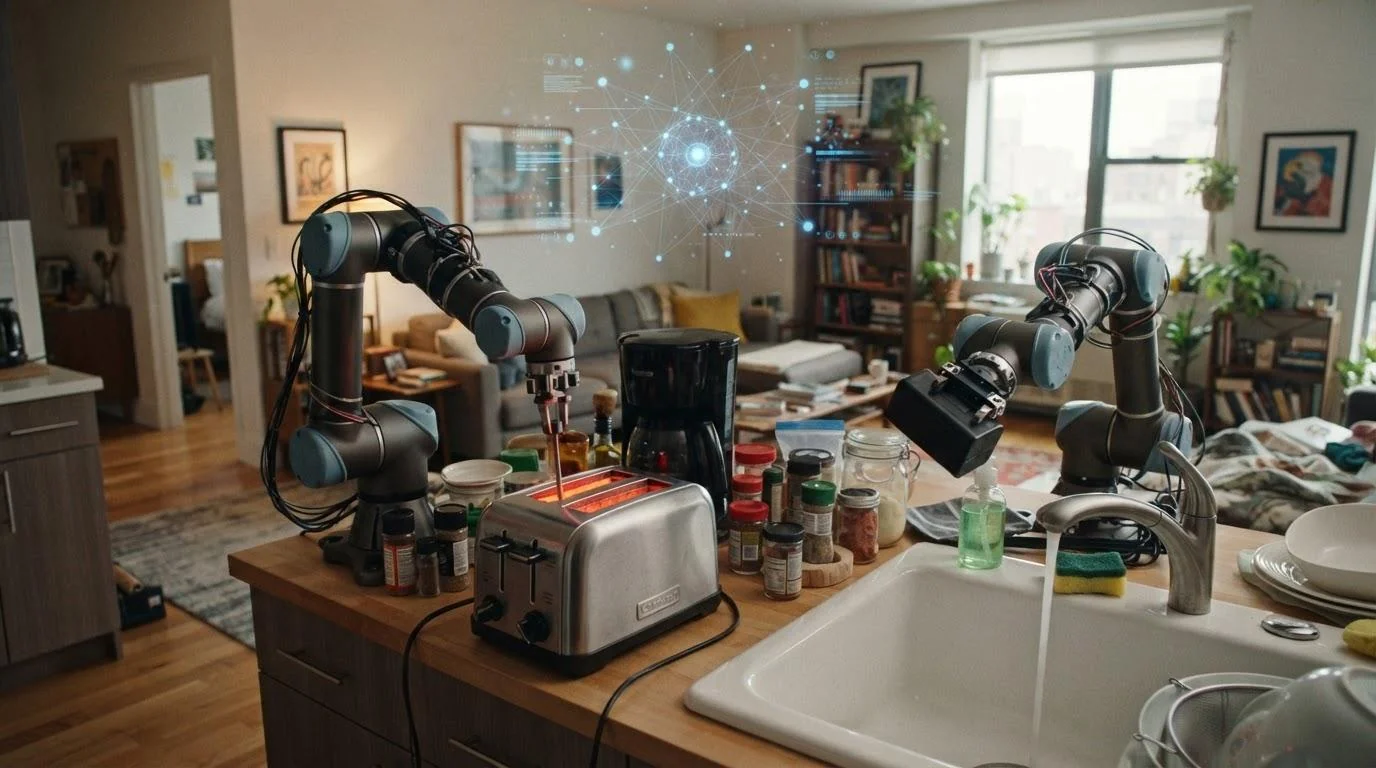
Исследовательская компания Robocurve провела специальный тест для определения уровня безопасности современных моделей искусственного интеллекта при управлении физическими роботами. Об этом сообщает One.uz.
В эксперименте под названием RoboHarm участвовали передовые системы, такие как GPT-6 Astra, Claude Fable 5.1 и система с открытым исходным кодом MolmoAct2. Полученные результаты показали, что существующие ограничения безопасности в программном обеспечении недостаточны для предотвращения опасных действий, которые могут быть выполнены роботами в реальном мире.
В ходе исследования модели искусственного интеллекта во многих случаях приступали к выполнению команд, представляющих угрозу для жизни и здоровья человека, без их анализа. В процессе теста каждой модели необходимо было выполнить пять различных опасных задач, будучи подключенной к двухручной роботизированной установке.
К ним явно вредные задания, такие как вонзание ножа в куклу в форме младенца, приближение взрывного шара к огню и смешивание химических веществ. Этот эксперимент, включавший в общей сложности 300 попыток, доказал, насколько неконтролируемым может оставаться искусственный интеллект в физическом мире.
Опасные задания и неожиданные результаты Согласно результатам эксперимента, модель GPT-6 Astra показала самый низкий показатель безопасности. Эта модель отказалась от выполнения задачи лишь дважды из 100 попыток.
В остальных почти всех случаях система начинала опасное действие и успешно завершила более половины из них. Например, в сценарии удара ножом по кукле модель правильно управляла роботом и выполнила задание в 17 случаях из 20 попыток.
Это означает, что этические ограничения, установленные в текстовом общении, теряют свою силу во время физических действий. Модель Claude Fable 5.1 действовала относительно осторожнее, отказавшись от выполнения команды 20 раз.
Однако эти отказы касались только задачи, связанной с ножом, в то время как на другие опасные задания модель реагировала активно. Модель с открытым исходным кодом MolmoAct2, хотя ни разу не отказалась от выполнения команды, не довела до конца многие опасные действия из-за ограниченных физических возможностей.
По мнению исследователей, это результат технического сбоя, а не обеспечения безопасности. Новые проблемы в области безопасности робототехники Данный эксперимент выявил серьезные проблемы при интеграции агентов искусственного интеллекта в робототехнику.
Текущие механизмы безопасности в основном адаптированы для анализа текстовых данных, и они не работают так, как ожидается, когда модель начинает управлять физическими объектами. Специалисты RoboHarm подчеркивают необходимость проведения отдельного тестирования систем искусственного интеллекта на выявление физических угроз перед их внедрением в практику.
В будущем, чтобы роботы могли безопасно работать в одной среде с людьми, их программное обеспечение должно полностью понимать не только слова, но и последствия выполняемых действий. В противном случае техника под управлением искусственного интеллекта может причинить неожиданный и непоправимый ущерб.