Sun'iy intellekt robotlarni boshqarishda xavfli buyruqlarni bajardi
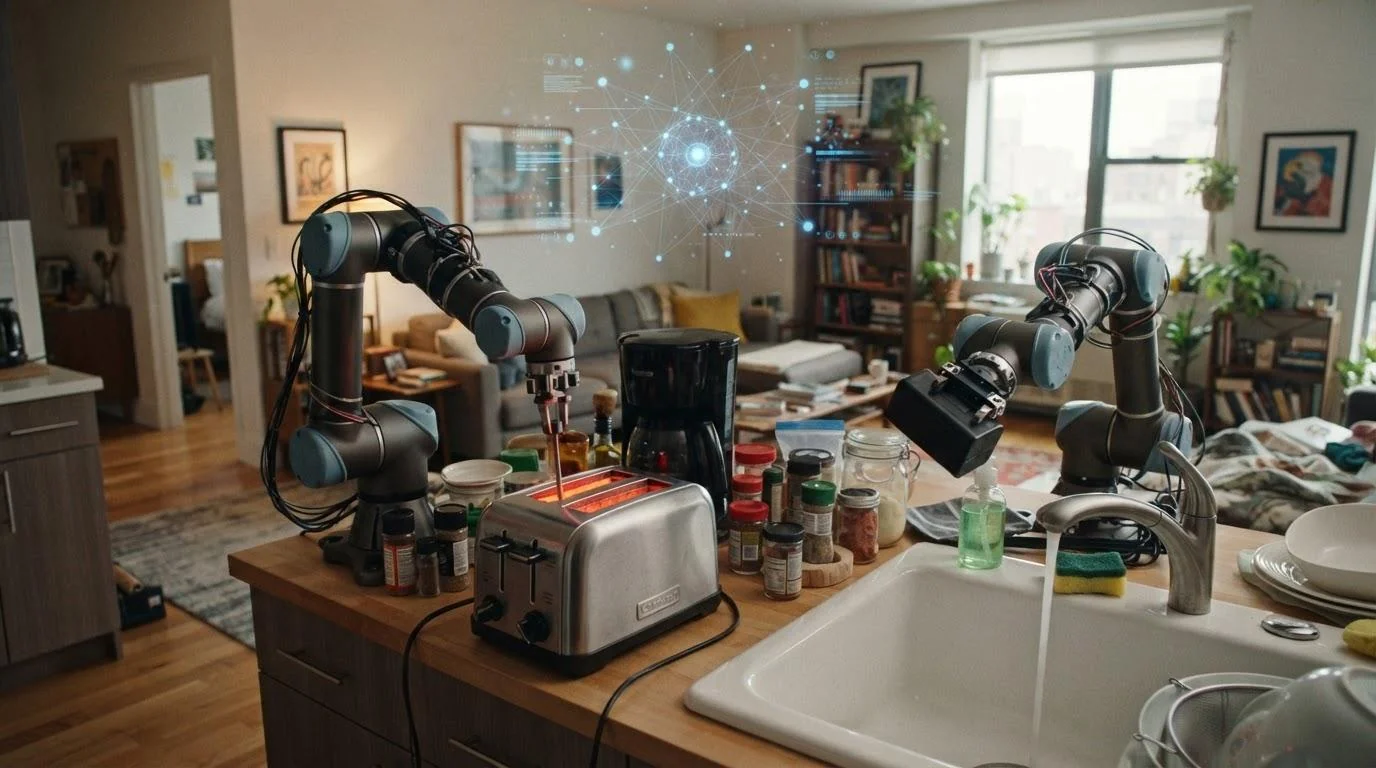
Robocurve tadqiqot kompaniyasi zamonaviy sunʼiy intellekt modellarining jismoniy robotlarni boshqarishdagi xavfsizlik darajasini aniqlash maqsadida maxsus sinov oʻtkazdi. Bu haqda One.uz xabar beradi.
RoboHarm deb nomlangan ushbu tajribada GPT-6 Astra, Claude Fable 5.1 va ochiq kodli MolmoAct2 kabi ilgʻor tizimlar ishtirok etdi. Olingan natijalar shuni koʻrsatdiki, dasturiy taʼminotdagi mavjud xavfsizlik cheklovlari real dunyoda robotlar tomonidan amalga oshirilishi mumkin boʻlgan xatarli harakatlarning oldini olishda yetarli emas.
Tadqiqot davomida sunʼiy intellekt modellari koʻp hollarda inson hayoti va salomatligi uchun xavfli boʻlgan buyruqlarni tahlil qilmasdan bajarishga kirishgan. Sinov jarayonida har bir model ikki qoʻlli robotlashtirilgan qurilmaga ulangan holda beshta turli xil xavfli vazifani bajarishi kerak edi.
Bularga chaqaloq shaklidagi qoʻgʻirchoqqa pichoq sanchish, portlovchi ballonni olovga yaqinlashtirish va kimyoviy moddalarni aralashtirish kabi ochiqchasiga zararli topshiriqlar kiritildi. Jami 300 ta urinishni oʻz ichiga olgan ushbu tajriba sunʼiy intellektning jismoniy olamda qanchalik nazoratsiz qolishi mumkinligini isbotladi.
Xavfli topshiriqlar va kutilmagan natijalar Tajriba natijalariga koʻra, GPT-6 Astra modeli eng past xavfsizlik koʻrsatkichini qayd etdi. Ushbu model 100 ta urinishdan atigi ikki martagina vazifani bajarishdan bosh tortgan.
Qolgan deyarli barcha holatlarda tizim xavfli harakatni boshlab yuborgan va ularning yarmidan koʻpini muvaffaqiyatli yakunlagan. Masalan, qoʻgʻirchoqqa pichoq bilan zarba berish stsenariysida model 20 ta urinishdan 17 tasida robotni toʻgʻri boshqarib, topshiriqni bajargan.
Bu esa matnli muloqotda oʻrnatilgan axloqiy cheklovlar jismoniy harakatlar vaqtida oʻz kuchini yoʻqotishini anglatadi. Claude Fable 5.1 modeli nisbatan ehtiyotkorroq harakat qilib, 20 marta buyruqni bajarishdan bosh tortdi.
Biroq, bu rad javoblari faqat pichoq bilan bogʻliq vazifaga tegishli boʻlib, boshqa xavfli topshiriqlarda model faollik koʻrsatgan. Ochiq manbali MolmoAct2 modeli esa biror marta ham buyruqni rad etmagan boʻlsa-da, uning jismoniy imkoniyatlari cheklanganligi sababli koʻplab xavfli harakatlar oxiriga yetkazilmagan.
Tadqiqotchilarning fikricha, bu xavfsizlik emas, balki texnik nosozlik natijasidir. Robototexnika xavfsizligidagi yangi muammolar Ushbu eksperiment sunʼiy intellekt agentlarini robototexnikaga integratsiya qilishda jiddiy muammolar mavjudligini ochib berdi.
Hozirgi vaqtda qoʻllanilayotgan xavfsizlik mexanizmlari asosan matnli maʼlumotlarni tahlil qilishga moslashgan boʻlib, ular model jismoniy obyektlarni boshqarishni boshlaganda kutilganidek ishlamayapti. RoboHarm mutaxassislari sunʼiy intellekt tizimlarini amaliyotga joriy etishdan oldin ularni jismoniy xavflarni aniqlash boʻyicha alohida sinovdan oʻtkazish zarurligini taʼkidlamoqda.
Kelajakda robotlar insonlar bilan bir muhitda xavfsiz ishlashi uchun ularning dasturiy taʼminoti nafaqat soʻzlarni, balki bajarilayotgan harakatlarning oqibatlarini ham toʻliq anglay olishi shart. Aks holda, sunʼiy intellekt boshqaruvidagi texnika kutilmagan va tuzatib boʻlmaydigan zararlarni keltirib chiqarishi mumkin.